09. Ablação do procedimento de seleção¶
Este notebook mede o próprio procedimento da AutoHybTS (§30.5 da especificação): quatro maneiras de escolher o modelo final, com o mesmo orçamento de busca e os mesmos testes externos.
Procedimento |
O que faz |
|---|---|
|
a finalista de menor erro em |
|
a cadeia incremental guardada (ganho ≥ 5%, vitórias ≥ 60%, variabilidade), todas as famílias |
|
a mesma cadeia, só estruturas com até 2 modelos (individual e híbrido aditivo) |
|
como |
As séries são sintéticas e diárias, com previsibilidade do resíduo em três níveis (estratos): AR(0) (nada a corrigir), AR(0,5) e AR(0,8). Cada série guarda os últimos 14 pontos como teste externo selado. Além da melhor base escolhida em V_select, cada linha traz o erro externo de naive e seasonal_naive como referências simples.
O orçamento limita só o número de candidatas (sem relógio), então a execução é reprodutível em outra máquina. O custo de cada procedimento inclui tudo o que ele roda: busca, seleção e, no guarded_nested, as buscas internas da CV aninhada.
O teste externo serve só para relatar. Não escolha o procedimento “vencedor” com ele: isso repetiria o erro que a ablação quer medir.
Esta é uma demonstração executável pequena: 3 séries sintéticas, uma semente, orçamento smoke e 2 origens de validação por camada. Ela verifica o fluxo e não estima desempenho científico. Congele um protocolo de pesquisa separado; fold="auto" resolve até 7 origens por camada. As saídas históricas da regra de 1% não são reaproveitadas.
import time

import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
from matplotlib.ticker import PercentFormatter

import autohybts
from autohybts.benchmarks import (
    PROCEDURES,
    ablation_protocol,
    ablation_report,
    ablation_uncertainty,
    run_ablation,
    synthetic_cases,
)

pd.set_option("display.width", 160)
pd.set_option("display.max_columns", 20)
print("AutoHybTS", autohybts.__version__)
AutoHybTS 1.0.0rc4
Perguntas¶
Pioras: a seleção guardada (
incremental,guarded_nested) é pior que a melhor base em menos casos quelowest_error?Ganhos úteis: quando o resíduo é previsível (AR(0,8)), os procedimentos guardados ainda escolhem o híbrido e ganham da base?
Complexidade: quanto da complexidade (híbridos, modelos ajustados) cada procedimento aceita quando não há o que aprender (AR(0))?
Custo: quanto custa cada procedimento, contando a CV aninhada?
As respostas valem só para estas séries, este horizonte e este orçamento.
1. Configuração¶
N_SERIES = 3
SEEDS = (0,)
BUDGET = "smoke"
SPACE = {
    "fold": 2,
    "base_models": ("naive", "seasonal_naive", "linear"),
    "correctors": ("linear",),
    "residual_windows": (7,),
    "alphas": (1.0,),
}

cases = list(synthetic_cases(N_SERIES))
protocol = ablation_protocol(cases, SEEDS, BUDGET, space=SPACE)
print("budget:", protocol["budget"])
pd.DataFrame(protocol["series"])
budget: {'preset': 'smoke', 'guard': {'mode': 'standard', 'max_trials_total': 10, 'max_trials_per_family': 4, 'max_candidates_per_stage': 6, 'max_refinements': 1, 'top_k_per_family': 2, 'top_k_residual_structures': 2, 'require_full_pairing': True, 'prefer_simpler_on_tie': True, 'allow_test_feedback_to_search': False}}
| series_id | length | horizon | test_size | seasonal_period | stratum | data_fingerprint | source | |
|---|---|---|---|---|---|---|---|---|
| 0 | syn0-phi0.0 | 400 | 14 | 14 | 7 | phi=0.0 | b64bb225f3693786c6ac6a32a8a3d029d9ed64a1c665b2... | {} |
| 1 | syn1-phi0.5 | 400 | 14 | 14 | 7 | phi=0.5 | 1bb5738517951a6bd9239cc84bc1e872459cfd5b04b2fa... | {} |
| 2 | syn2-phi0.8 | 400 | 14 | 14 | 7 | phi=0.8 | ee5d0e4d2cda098925d7f6be165c10927a37bc5d185de9... | {} |
2. Execução¶
Para cada série e semente: uma busca com todas as famílias (serve a lowest_error, incremental e guarded_nested), uma busca restrita (incremental_simple) e a CV aninhada (guarded_nested). Cada candidata é avaliada uma única vez no teste externo.
started = time.perf_counter()
table = run_ablation(cases, seeds=SEEDS, budget=BUDGET, space=SPACE)
print(f"{len(table)} linhas em {(time.perf_counter() - started) / 60:.1f} min")
print("paradas da busca:", table["stop_reason"].value_counts().to_dict())
print(
    "podas por limite:",
    table.drop_duplicates(["series_id", "seed", "search"])["pruned_by"].value_counts().to_dict(),
)
table[["series_id", "seed", "procedure", "champion", "test_score", "gain_vs_base"]].head(8)
12 linhas em 3.4 min
paradas da busca: {'max_trials_total': 9, 'budget_limited': 3}
podas por limite: {'max_trials_per_family:3;max_trials_total:5': 3, 'max_trials_per_family:1': 3}
| series_id | seed | procedure | champion | test_score | gain_vs_base | |
|---|---|---|---|---|---|---|
| 0 | syn0-phi0.0 | 0 | lowest_error | comb(linear,seasonal_naive) | 0.918190 | 0.115798 |
| 1 | syn0-phi0.0 | 0 | incremental | comb(linear,seasonal_naive) | 0.918190 | 0.115798 |
| 2 | syn0-phi0.0 | 0 | incremental_simple | linear | 0.916736 | 0.117199 |
| 3 | syn0-phi0.0 | 0 | guarded_nested | seasonal_naive | 1.038440 | 0.000000 |
| 4 | syn1-phi0.5 | 0 | lowest_error | linear-linear | 0.824160 | 0.280218 |
| 5 | syn1-phi0.5 | 0 | incremental | linear | 1.145013 | 0.000000 |
| 6 | syn1-phi0.5 | 0 | incremental_simple | linear | 1.145013 | 0.000000 |
| 7 | syn1-phi0.5 | 0 | guarded_nested | linear | 1.145013 | 0.000000 |
3. Resumo por procedimento¶
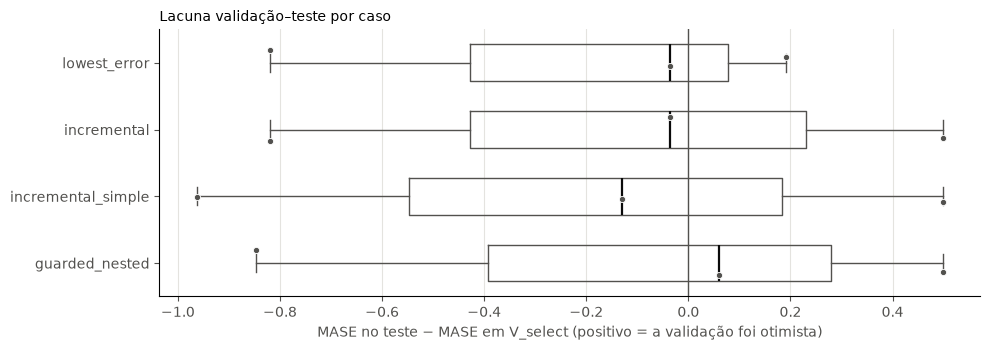
median_gain_vs_base: ganho mediano no teste contra a melhor base individual deV_select(positivo = melhor).beats_base_share,ties_base_share,worse_than_base_share: frações de casos melhores, iguais e piores que essa base.hybrid_shareemean_complexity: fração de híbridos escolhidos e número médio de modelos ajustados na estrutura.mean_gap: erro no teste menos erro emV_select(positivo = a validação foi otimista).mean_rank: posto médio no teste entre os 4 procedimentos (menor = melhor).mean_seconds,candidates,units: custo médio do procedimento (sem o reajuste final nem a leitura do teste).seed_std_of_median_gain: quanto o ganho mediano varia entre sementes.
report = ablation_report(table)
report.round(4)
| median_gain_vs_base | beats_base_share | ties_base_share | worse_than_base_share | n_rows | n_paired | hybrid_share | mean_complexity | mean_gap | mean_rank | coverage | mean_seconds | candidates | units | seed_std_of_median_gain | n_invalid_gain | paired_coverage | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| procedure | |||||||||||||||||
| lowest_error | 0.1158 | 1.0000 | 0.0000 | 0.0 | 3 | 3 | 1.0000 | 2.0000 | -0.2218 | 2.0000 | 1.0 | 22.5417 | 10.0 | 30.0 | NaN | 0 | 1.0 |
| incremental | 0.1011 | 0.6667 | 0.3333 | 0.0 | 3 | 3 | 0.6667 | 1.6667 | -0.1194 | 2.6667 | 1.0 | 22.5417 | 10.0 | 30.0 | NaN | 0 | 1.0 |
| incremental_simple | 0.1172 | 0.6667 | 0.3333 | 0.0 | 3 | 3 | 0.0000 | 1.0000 | -0.1985 | 1.6667 | 1.0 | 1.5522 | 7.0 | 20.0 | NaN | 0 | 1.0 |
| guarded_nested | 0.0000 | 0.0000 | 1.0000 | 0.0 | 3 | 3 | 0.0000 | 1.0000 | -0.0961 | 3.6667 | 1.0 | 65.5380 | 30.0 | 90.0 | NaN | 0 | 1.0 |
Incerteza¶
As sementes de uma série não são independentes: o ganho de cada série é resumido (mediana entre sementes) e o intervalo de 95% reamostra séries.
ablation_uncertainty(table).round(4)
| n_series | n_paired_series | n_invalid_series | paired_series_coverage | median_gain_vs_base | ci_low | ci_high | better_share | worse_share | |
|---|---|---|---|---|---|---|---|---|---|
| procedure | |||||||||
| lowest_error | 3 | 3 | 0 | 1.0 | 0.1158 | 0.1011 | 0.2802 | 1.0000 | 0.0 |
| incremental | 3 | 3 | 0 | 1.0 | 0.1011 | 0.0000 | 0.1158 | 0.6667 | 0.0 |
| incremental_simple | 3 | 3 | 0 | 1.0 | 0.1172 | 0.0000 | 0.1309 | 0.6667 | 0.0 |
| guarded_nested | 3 | 3 | 0 | 1.0 | 0.0000 | 0.0000 | 0.0000 | 0.0000 | 0.0 |
4. Por nível de previsibilidade do resíduo¶
Quando o resíduo é ruído branco (AR(0)), um híbrido não tem o que aprender: o bom procedimento deveria ficar com a base. Com AR(0,8), há o que corrigir.
Primeiro, cada caso como um ponto (os empates com a base ficam visíveis em cinza); depois, por estrato, a fração de casos melhor, igual e pior que a base.
by_stratum = ablation_report(table, by="stratum")
columns = ["median_gain_vs_base", "beats_base_share", "worse_than_base_share", "hybrid_share"]
by_stratum[columns].round(3)
| median_gain_vs_base | beats_base_share | worse_than_base_share | hybrid_share | ||
|---|---|---|---|---|---|
| stratum | procedure | ||||
| phi=0.0 | lowest_error | 0.116 | 1.0 | 0.0 | 1.0 |
| incremental | 0.116 | 1.0 | 0.0 | 1.0 | |
| incremental_simple | 0.117 | 1.0 | 0.0 | 0.0 | |
| guarded_nested | 0.000 | 0.0 | 0.0 | 0.0 | |
| phi=0.5 | lowest_error | 0.280 | 1.0 | 0.0 | 1.0 |
| incremental | 0.000 | 0.0 | 0.0 | 0.0 | |
| incremental_simple | 0.000 | 0.0 | 0.0 | 0.0 | |
| guarded_nested | 0.000 | 0.0 | 0.0 | 0.0 | |
| phi=0.8 | lowest_error | 0.101 | 1.0 | 0.0 | 1.0 |
| incremental | 0.101 | 1.0 | 0.0 | 1.0 | |
| incremental_simple | 0.131 | 1.0 | 0.0 | 0.0 | |
| guarded_nested | 0.000 | 0.0 | 0.0 | 0.0 |
# Visual: thin marks, recessive grid, one colour per meaning (better / tie / worse).
INK, MUTED, GRID = "#0b0b0b", "#52514e", "#e4e3df"
BETTER, TIE, WORSE = "#2a78d6", "#c3c2b7", "#eb6834"
order = list(PROCEDURES)


def clean(ax, grid_axis="x"):
    ax.grid(axis=grid_axis, color=GRID, linewidth=0.8)
    ax.set_axisbelow(True)
    for side in ("top", "right"):
        ax.spines[side].set_visible(False)
    ax.tick_params(colors=MUTED)


def cases(ax, column, xlabel, signed=True):
    """Box per procedure with every case on top (zeros stay visible).

    ``signed`` colours points by better / tie / worse; otherwise they stay neutral.
    """
    rng = np.random.default_rng(0)
    for row, procedure in enumerate(order):
        values = table.loc[table["procedure"] == procedure, column].to_numpy()
        ax.boxplot(
            values,
            positions=[row],
            orientation="horizontal",
            widths=0.55,
            showfliers=False,
            medianprops={"color": INK, "linewidth": 1.6},
            boxprops={"color": MUTED},
            whiskerprops={"color": MUTED},
            capprops={"color": MUTED},
        )
        colors = np.where(values > 0, BETTER, np.where(values < 0, WORSE, TIE)) if signed else MUTED
        ax.scatter(
            values,
            row + rng.uniform(-0.2, 0.2, values.size),
            s=20,
            c=colors,
            edgecolors="white",
            linewidths=0.6,
            zorder=3,
        )
    ax.axvline(0, color=MUTED, linewidth=1)
    ax.set_yticks(range(len(order)), order)
    ax.invert_yaxis()  # same top-to-bottom order as the stacked bars
    ax.set_xlabel(xlabel, color=MUTED)
    clean(ax)


fig, ax = plt.subplots(figsize=(10, 3.8))
cases(ax, "gain_vs_base", "ganho no teste contra a melhor base de V_select (positivo = melhor)")
ax.set_title(
    "Ganho por caso — cada ponto é uma série × semente (azul: melhor, cinza: igual, laranja: pior)",
    loc="left",
    fontsize=10,
)
fig.tight_layout()

labels = {"melhor": BETTER, "igual": TIE, "pior": WORSE}
outcome = np.select(
    [table["gain_vs_base"] > 0, table["gain_vs_base"] < 0], ["melhor", "pior"], "igual"
)
shares = (
    table.assign(resultado=outcome)
    .groupby(["stratum", "procedure"])["resultado"]
    .value_counts(normalize=True)
    .unstack(fill_value=0)
    .reindex(columns=list(labels), fill_value=0)
)
strata = sorted(table["stratum"].unique())
fig, axes = plt.subplots(1, len(strata), figsize=(13, 3.4), sharey=True)
for ax, stratum in zip(axes, strata, strict=True):
    part = shares.loc[stratum].reindex(order[::-1])
    left = np.zeros(len(part))
    for label, color in labels.items():
        values = part[label].to_numpy()
        ax.barh(
            part.index,
            values,
            left=left,
            color=color,
            height=0.6,
            edgecolor="#fcfcfb",
            linewidth=2,
            label=label,
        )
        for y, (value, start) in enumerate(zip(values, left, strict=True)):
            if value >= 0.12:
                ax.text(
                    start + value / 2,
                    y,
                    f"{value:.0%}",
                    ha="center",
                    va="center",
                    fontsize=8,
                    color=INK,
                )
        left += values
    ax.set_title(stratum.replace("phi=", "AR φ = "), loc="left", fontsize=10)
    ax.set_xlim(0, 1)
    ax.xaxis.set_major_formatter(PercentFormatter(1))
    clean(ax)
handles, names = axes[0].get_legend_handles_labels()
fig.legend(
    handles,
    [f"{n} que a base" if n != "igual" else "igual à base" for n in names],
    loc="upper right",
    ncol=3,
    frameon=False,
    fontsize=9,
)
fig.suptitle(
    "Resultado contra a melhor base, por previsibilidade do resíduo", x=0.01, ha="left", fontsize=11
)
fig.tight_layout(rect=(0, 0, 1, 0.9))

5. Otimismo da validação¶
Lacuna = erro no teste − erro em V_select. Um procedimento que escolhe pelo menor erro tende a pegar a candidata que teve sorte na validação; a lacuna mostra quanto disso aparece no teste.
fig, ax = plt.subplots(figsize=(10, 3.6))
cases(
    ax,
    "gap",
    "MASE no teste − MASE em V_select (positivo = a validação foi otimista)",
    signed=False,
)
ax.set_title("Lacuna validação–teste por caso", loc="left", fontsize=10)
fig.tight_layout()
6. Custo¶
Segundos por fase (média por caso) e trabalho feito. lowest_error, incremental e guarded_nested compartilham a mesma busca (coluna search): o custo de busca deles é o mesmo trabalho, não três medidas. O guarded_nested soma as buscas internas da CV aninhada (nested_candidates). seconds_refit (reajuste do escolhido antes do teste) e seconds_external (leitura do teste) são relato, não custo do procedimento.
cost_columns = [
    "seconds",
    "seconds_search",
    "seconds_selection",
    "seconds_nested",
    "seconds_refit",
    "seconds_external",
    "candidates",
    "search_candidates",
    "nested_candidates",
    "pruned_candidates",
    "units",
    "max_trials_total",
]
table.groupby("procedure")[cost_columns].mean().loc[order].round(2)
| seconds | seconds_search | seconds_selection | seconds_nested | seconds_refit | seconds_external | candidates | search_candidates | nested_candidates | pruned_candidates | units | max_trials_total | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| procedure | ||||||||||||
| lowest_error | 22.54 | 21.74 | 0.81 | 0.0 | 0.12 | 0.03 | 10.0 | 10.0 | 0.0 | 8.0 | 30.0 | 10.0 |
| incremental | 22.54 | 21.74 | 0.81 | 0.0 | 0.05 | 0.03 | 10.0 | 10.0 | 0.0 | 8.0 | 30.0 | 10.0 |
| incremental_simple | 1.55 | 1.03 | 0.52 | 0.0 | 0.00 | 0.02 | 7.0 | 7.0 | 0.0 | 1.0 | 20.0 | 10.0 |
| guarded_nested | 65.54 | 21.74 | 0.81 | 43.0 | 0.00 | 0.02 | 30.0 | 10.0 | 20.0 | 8.0 | 90.0 | 10.0 |
7. Estruturas escolhidas e referências simples¶
chosen = table.groupby("procedure")["champion"].value_counts().unstack(fill_value=0).T
references = table.drop_duplicates(["series_id", "seed"])[
    ["best_base_test", "naive_test", "seasonal_naive_test"]
].median()
print("MASE mediana no teste das referências:", references.round(3).to_dict())
chosen
MASE mediana no teste das referências: {'best_base_test': 1.038, 'naive_test': 1.744, 'seasonal_naive_test': 1.038}
| procedure | guarded_nested | incremental | incremental_simple | lowest_error |
|---|---|---|---|---|
| champion | ||||
| comb(linear,seasonal_naive) | 0 | 1 | 0 | 1 |
| linear | 1 | 1 | 3 | 0 |
| linear-linear | 0 | 0 | 0 | 1 |
| ma(linear-linear) | 0 | 1 | 0 | 1 |
| seasonal_naive | 2 | 0 | 0 | 0 |
8. Tabela e protocolo resolvido¶
As saídas vão para artifacts/ablation/ (fora do git). Demonstração retomável pela CLI: python -m autohybts.benchmarks.ablation --config tools/protocols/ablation_demo.json --checkpoint artifacts/demo.sqlite --out artifacts/demo.csv; acrescente --resume para continuar. Esse exemplo menor da CLI usa uma série.
import json
from pathlib import Path

folder = Path("artifacts") / "ablation"
folder.mkdir(parents=True, exist_ok=True)
table.to_csv(folder / "ablation.csv", index=False)
(folder / "ablation.protocol.json").write_text(
    json.dumps(table.attrs["protocol"], indent=2, ensure_ascii=False, default=str), encoding="utf-8"
)
print(sorted(p.name for p in folder.iterdir()))
['ablation.csv', 'ablation.protocol.json']
9. Leitura da demonstração¶
Confira cobertura (n_paired, n_invalid_gain), pioras, ganhos, complexidade e custos acima. Uma série por estrato e uma semente não sustentam comparação científica, incluindo os intervalos bootstrap. Não escolha o procedimento pelo teste externo. Para o artigo, congele séries, sementes, orçamento, dobras e critérios de aceite em uma configuração separada e execute o estudo real. O esquema ablation/3 registra a referência corrigida; nunca reclassifique resultados anteriores como versão 3.