06. Comparar modelos e validação cruzada temporal
Como ler o resultado da busca e comparar modelos com rigor:
Ranking das finalistas na camada de seleção (
V_select).Validação cruzada temporal (rolling origin) com dobras próprias, para comparar vários modelos nas mesmas origens.
Testes estatísticos (Wilcoxon e Diebold-Mariano com Holm; Friedman com diferença crítica de Nemenyi).
Comparação final no teste selado, uma avaliação por modelo.
Validação cruzada aninhada do procedimento inteiro: quanto a seleção automática generaliza.
Tabelas e testes servem ao relatório: a escolha do campeão segue a regra do protocolo, e o teste selado nunca volta para a busca.
import autohybts

print("AutoHybTS", autohybts.__version__)
AutoHybTS 1.0.0rc4
1. Experimento e busca
from autohybts import AutoHybridExperiment
from autohybts.datasets import get_data

y = get_data("synthetic_daily")
exp = AutoHybridExperiment(
    fh=14,
    session_id=42,
    progress=True,
    fold=3,
    base_models=["naive", "seasonal_naive", "linear", "knn", "mlp"],
    correctors=["linear", "knn"],
    residual_windows=[7],
).fit(y)
result = exp.compare_models()
result.best
busca S0 bases: 0%| | 0/5 [00:00<?, ?cand/s]
busca S0 bases: 60%|██████ | 3/5 [00:01<00:01, 1.72cand/s]
busca S0 bases: 80%|████████ | 4/5 [00:01<00:00, 2.32cand/s]
busca S0 bases: 100%|██████████| 5/5 [00:02<00:00, 1.58cand/s]
busca S0 bases: 100%|██████████| 5/5 [00:02<00:00, 1.70cand/s]
busca S2 resíduos: 0%| | 0/11 [00:00<?, ?cand/s]
busca S2 resíduos: 9%|▉ | 1/11 [00:02<00:29, 2.94s/cand]
busca S2 resíduos: 18%|█▊ | 2/11 [00:05<00:23, 2.57s/cand]
busca S2 resíduos: 27%|██▋ | 3/11 [00:05<00:13, 1.64s/cand]
busca S2 resíduos: 36%|███▋ | 4/11 [00:06<00:09, 1.34s/cand]
busca S2 resíduos: 45%|████▌ | 5/11 [00:07<00:06, 1.03s/cand]
busca S2 resíduos: 55%|█████▍ | 6/11 [00:09<00:08, 1.61s/cand]
busca S2 resíduos: 64%|██████▎ | 7/11 [00:11<00:06, 1.55s/cand]
busca S2 resíduos: 73%|███████▎ | 8/11 [00:11<00:03, 1.14s/cand]
busca S2 resíduos: 82%|████████▏ | 9/11 [00:12<00:01, 1.07cand/s]
busca S2 resíduos: 91%|█████████ | 10/11 [00:12<00:00, 1.41cand/s]
busca S2 resíduos: 100%|██████████| 11/11 [00:14<00:00, 1.18s/cand]
busca S2 resíduos: 100%|██████████| 11/11 [00:14<00:00, 1.32s/cand]
busca S3 refino: 0%| | 0/2 [00:00<?, ?cand/s]
busca S3 refino: 50%|█████ | 1/2 [00:02<00:02, 2.11s/cand]
busca S3 refino: 100%|██████████| 2/2 [00:04<00:00, 2.44s/cand]
busca S3 refino: 100%|██████████| 2/2 [00:04<00:00, 2.39s/cand]
seleção V_select: 0%| | 0/5 [00:00<?, ?cand/s]
seleção V_select: 20%|██ | 1/5 [00:00<00:01, 2.03cand/s]
seleção V_select: 40%|████ | 2/5 [00:01<00:03, 1.00s/cand]
seleção V_select: 100%|██████████| 5/5 [00:01<00:00, 2.64cand/s]
CandidateSpec(family='residual', strategy='residual_additive', base=ModelSpec(name='mlp', params_json='{"lags":7}'), corrector=ModelSpec(name='linear', params_json='{}'), window_size=7, alpha=0.5, residual_source='historical_oof_1step', variant='A', members=(), options_json='{}', components=(), exog=(), candidate_id='9fd962cca51322c0e3697027ac96d1fa8d35c2672647b0030737ef663dde6df6')
2. Ranking das finalistas em V_select
Uma finalista por família, com o campeão como referência (primeira linha da comparação). mean_rank é o posto médio entre as origens de seleção.
result.comparison.summary
| mean | std | median | n_valid | n_units | mean_rank | |
|---|---|---|---|---|---|---|
| model | ||||||
| mlp-linear | 1.608653 | 0.449332 | 1.689824 | 3 | 3 | 2.333333 |
| seasonal_naive | 1.741253 | 0.454019 | 1.500052 | 3 | 3 | 2.666667 |
| mlp | 1.706069 | 0.583338 | 1.571487 | 3 | 3 | 3.000000 |
| linear | 1.791337 | 0.556332 | 1.639575 | 3 | 3 | 3.333333 |
| knn | 1.861741 | 0.935903 | 1.742845 | 3 | 3 | 3.666667 |
result.comparison.plot("leaderboard")

3. Validação cruzada temporal
Dobras próprias sobre o histórico de desenvolvimento (o teste selado fica de fora): 8 origens, uma a cada 7 dias, cada uma prevendo 14 passos. Todos os modelos são avaliados nas mesmas origens. Opções: folds, step, fold_strategy ("expanding" ou "rolling"), window_size e horizon.
cv = exp.cross_validate(folds=8, step=7)
cv.splits
validação cruzada: 0%| | 0/5 [00:00<?, ?cand/s]
validação cruzada: 20%|██ | 1/5 [00:03<00:12, 3.19s/cand]
validação cruzada: 40%|████ | 2/5 [00:04<00:06, 2.00s/cand]
validação cruzada: 100%|██████████| 5/5 [00:04<00:00, 1.67cand/s]
validação cruzada: 100%|██████████| 5/5 [00:04<00:00, 1.12cand/s]
| layer | train_start | origin | first_target | last_target | n_train | horizon | |
|---|---|---|---|---|---|---|---|
| fold_id | |||||||
| cv-0 | cv | 2024-01-01 | 2025-10-14 | 2025-10-15 | 2025-10-28 | 653 | 14 |
| cv-1 | cv | 2024-01-01 | 2025-10-21 | 2025-10-22 | 2025-11-04 | 660 | 14 |
| cv-2 | cv | 2024-01-01 | 2025-10-28 | 2025-10-29 | 2025-11-11 | 667 | 14 |
| cv-3 | cv | 2024-01-01 | 2025-11-04 | 2025-11-05 | 2025-11-18 | 674 | 14 |
| cv-4 | cv | 2024-01-01 | 2025-11-11 | 2025-11-12 | 2025-11-25 | 681 | 14 |
| cv-5 | cv | 2024-01-01 | 2025-11-18 | 2025-11-19 | 2025-12-02 | 688 | 14 |
| cv-6 | cv | 2024-01-01 | 2025-11-25 | 2025-11-26 | 2025-12-09 | 695 | 14 |
| cv-7 | cv | 2024-01-01 | 2025-12-02 | 2025-12-03 | 2025-12-16 | 702 | 14 |
cv.summary
| mean | std | median | n_valid | n_units | mean_rank | |
|---|---|---|---|---|---|---|
| model | ||||||
| mlp | 1.294039 | 0.592503 | 1.221063 | 8 | 8 | 2.250 |
| linear | 1.391870 | 0.503800 | 1.351495 | 8 | 8 | 2.875 |
| seasonal_naive | 1.401389 | 0.399431 | 1.349723 | 8 | 8 | 3.000 |
| mlp-linear | 1.500562 | 0.613733 | 1.445802 | 8 | 8 | 3.250 |
| knn | 1.464256 | 0.645633 | 1.111622 | 8 | 8 | 3.625 |
cv.units # MASE por origem e modelo
| mlp-linear | mlp | knn | seasonal_naive | linear | |
|---|---|---|---|---|---|
| cv-0 | 0.752621 | 0.585961 | 1.106167 | 0.973660 | 0.848262 |
| cv-1 | 2.097688 | 1.129454 | 1.081310 | 1.372579 | 1.376356 |
| cv-2 | 1.266502 | 1.312672 | 1.793738 | 1.326866 | 1.545608 |
| cv-3 | 2.512821 | 2.470001 | 2.851411 | 2.264966 | 2.407803 |
| cv-4 | 0.959965 | 0.772428 | 1.117078 | 1.000031 | 0.845120 |
| cv-5 | 1.789340 | 1.647708 | 0.990967 | 1.500052 | 1.639575 |
| cv-6 | 1.625103 | 0.955602 | 1.030533 | 1.314213 | 1.145602 |
| cv-7 | 1.000457 | 1.478483 | 1.742845 | 1.458741 | 1.326634 |
Visualizações
cv.plot("leaderboard")

cv.plot("boxplot")

cv.plot("metric_by_fold")

cv.plot("win_rate")

cv.plot("forecasts")

Testes estatísticos
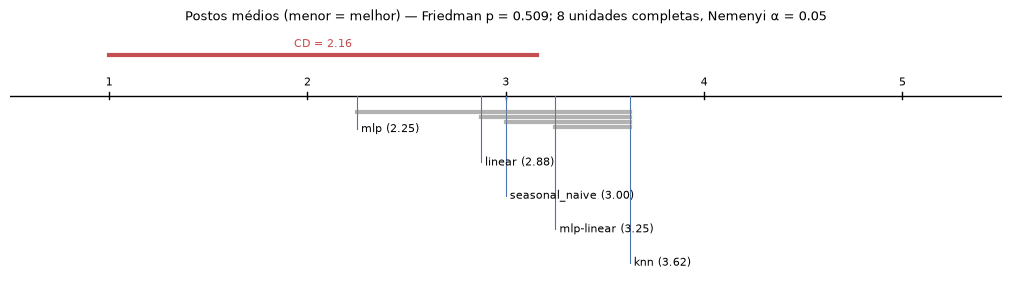
Cada modelo contra a referência (o campeão): Wilcoxon pareado e Diebold-Mariano (variância de Newey-West, para origens com alvos sobrepostos), com correção de Holm. O teste de Friedman e a diferença crítica de Nemenyi comparam todos ao mesmo tempo.
Com poucas origens os testes têm pouco poder: “sem diferença significativa” não quer dizer que os modelos são equivalentes.
cv.tests()
| model | reference | n_units | mean_difference | median_difference | wins | wilcoxon_p | dm_statistic | dm_p | wilcoxon_p_holm | dm_p_holm | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | mlp | mlp-linear | 8 | 0.206523 | 0.154146 | 6 | 0.195312 | 1.807143 | 0.113690 | 0.78125 | 0.454758 |
| 1 | knn | mlp-linear | 8 | 0.036306 | -0.247851 | 3 | 0.843750 | 0.191534 | 0.853544 | 1.00000 | 0.853544 |
| 2 | seasonal_naive | mlp-linear | 8 | 0.099174 | 0.103894 | 4 | 0.546875 | 1.117511 | 0.300657 | 1.00000 | 0.617275 |
| 3 | linear | mlp-linear | 8 | 0.108692 | 0.109931 | 5 | 0.460938 | 1.394727 | 0.205758 | 1.00000 | 0.617275 |
friedman = cv.friedman()
p_value, cd = friedman["p_value"], friedman["critical_difference"]
print(f"Friedman p = {p_value:.3f}; diferença crítica = {cd:.2f}")
friedman["mean_ranks"].sort_values()
Friedman p = 0.509; diferença crítica = 2.16
mlp               2.250
linear            2.875
seasonal_naive    3.000
mlp-linear        3.250
knn               3.625
dtype: float64
cv.plot("critical_difference")
4. Comparação final no teste selado
Cada modelo é finalizado (reajuste no histórico anterior ao teste) e avaliado uma única vez. É um relato terminal: mudar a configuração por causa dele transformaria o teste em validação.
external = exp.compare_external()
external.table
teste externo: 0%| | 0/5 [00:00<?, ?cand/s]
teste externo: 20%|██ | 1/5 [00:00<00:01, 2.18cand/s]
teste externo: 40%|████ | 2/5 [00:00<00:00, 3.56cand/s]
teste externo: 100%|██████████| 5/5 [00:00<00:00, 7.63cand/s]
| MASE | MAE | RMSE | sMAPE | ganho_MASE_vs_ref | |
|---|---|---|---|---|---|
| model | |||||
| mlp(lags=7) + linear [w=7, alpha=0.5, historical_oof_1step] | 0.703257 | 1.101274 | 1.288316 | 0.015685 | 0.000000 |
| mlp(lags=7) | 1.193216 | 1.868531 | 2.137723 | 0.026300 | -0.696699 |
| knn(lags=7) | 0.549934 | 0.861176 | 1.036616 | 0.012319 | 0.218018 |
| seasonal_naive(season_length=7) | 0.826938 | 1.294953 | 1.560511 | 0.018222 | -0.175868 |
| linear(lags=7) | 0.660951 | 1.035024 | 1.157793 | 0.014720 | 0.060158 |
external.tests
| model | dm_statistic | dm_p | dm_p_holm | |
|---|---|---|---|---|
| 0 | mlp(lags=7) | -6.490174 | 0.000020 | 0.000081 |
| 1 | knn(lags=7) | 1.611410 | 0.131092 | 0.279398 |
| 2 | seasonal_naive(season_length=7) | -1.812039 | 0.093133 | 0.279398 |
| 3 | linear(lags=7) | 1.527034 | 0.150710 | 0.279398 |
5. Validação cruzada aninhada do procedimento
Em cada dobra externa, a AutoHybTS refaz busca e seleção usando só o passado e é medida no bloco seguinte, ao lado de referências. Responde à pergunta: escolher automaticamente compensa?
best_standaloneé a melhor base da seleção interna de cada dobra, escolhida sem o bloco externo: a referência justa para saber se a hibridação compensa.naiveeseasonal_naivesão referências fixas.As buscas internas repetem as famílias do último
compare_models(nested.include), enested.costmostra o trabalho de cada dobra.
nested = exp.nested_cross_validate(outer_folds=3, budget="smoke")
print("famílias das buscas internas:", nested.include)
nested.folds[
    ["champion", "best_standalone", "autohybts_MASE", "best_standalone_MASE", "naive_MASE"]
]
CV aninhada: 0%| | 0/3 [00:00<?, ?cand/s]
CV aninhada: 33%|███▎ | 1/3 [00:02<00:04, 2.43s/cand]
CV aninhada: 67%|██████▋ | 2/3 [00:04<00:02, 2.34s/cand]
CV aninhada: 100%|██████████| 3/3 [00:07<00:00, 2.42s/cand]
CV aninhada: 100%|██████████| 3/3 [00:07<00:00, 2.41s/cand]
famílias das buscas internas: ('standalone', 'residual')
| champion | best_standalone | autohybts_MASE | best_standalone_MASE | naive_MASE | |
|---|---|---|---|---|---|
| fold_id | |||||
| cv-0 | mlp(lags=7) | linear(lags=7) | 2.373193 | 2.407803 | 1.399396 |
| cv-1 | seasonal_naive(season_length=7) | seasonal_naive(season_length=7) | 1.500052 | 1.500052 | 3.438511 |
| cv-2 | mlp(lags=7) | seasonal_naive(season_length=7) | 1.230691 | 1.458741 | 1.422165 |
nested.summary
| mean | std | n_folds | autohybts_wins | |
|---|---|---|---|---|
| autohybts_MASE | 1.701312 | 0.597250 | 3 | NaN |
| best_standalone_MASE | 1.788865 | 0.536414 | 3 | 0.666667 |
| naive_MASE | 2.086690 | 1.170766 | 3 | 0.666667 |
| seasonal_naive_MASE | 1.741253 | 0.454019 | 3 | 0.333333 |
nested.cost[["search_candidates", "search_units", "select_units", "stop_reason", "seconds_total"]]
| search_candidates | search_units | select_units | stop_reason | seconds_total | |
|---|---|---|---|---|---|
| fold_id | |||||
| cv-0 | 9 | 27 | 15 | budget_limited | 2.430689 |
| cv-1 | 9 | 27 | 15 | budget_limited | 2.281348 |
| cv-2 | 9 | 27 | 15 | budget_limited | 2.502493 |